Klarer du fortsatt å se forskjell på ekte bilder og AI-bilder? Dette sier forskningen
Sist faktasjekket:
Kort oppsummert
De fleste av oss klarer det bare så vidt. En fagfellevurdert studie med over 12 500 deltakere fant at folk kjente igjen AI-bilder i rundt 62 prosent av tilfellene, bare litt bedre enn å gjette tilfeldig. En egen analyse fra Association for Computing Machinery beskriver evnen vår som “so-so”, nesten som et myntkast.
Hva viser forskningen konkret?
“Folk sier de alltid kan se et AI-bilde, jeg er ikke så sikker lenger”, skrev en bruker på Reddit i en tråd som fikk stor oppmerksomhet i 2026. Varianter av det samme spørsmålet dukker opp igjen og igjen i ulike nettmiljøer, og forskningen gir et ganske klart svar:
- 62 prosent gjenkjenningsrate på tvers av 12 500 deltakere. En studie publisert på arXiv i 2025 testet deltakere fra hele verden på ulike typer bilder. Samlet lå treffsikkerheten like over gjettenivået, som er 50 prosent.
- Store forskjeller mellom bildetyper. Deltakerne var klart best til å kjenne igjen AI-genererte menneskeportretter og betydelig dårligere på natur- og bylandskap, ifølge samme studie. Det tyder på at “vanskelighetsgraden” avhenger mye av hva bildet faktisk viser, og ikke bare av hvor avansert modellen bak bildet er.
- “As Good as a Coin Toss.” En egen analyse fra Association for Computing Machinery brukte nettopp denne overskriften da den oppsummerte funnene fra flere studier. Konklusjonen var at mennesker generelt er dårlige til å skille syntetiske bilder, lyd, video og audiovisuelt innhold fra ekte.
- Litt trening hjelper mer enn du skulle tro. Forskere ved Northwestern Universitys Kellogg School testet dette på etterretningsanalytikere. De fant at bare 30 minutters målrettet opplæring kan gi en merkbar forbedring i evnen til å skille ekte bilder fra falske, sammenlignet med ingen trening i det hele tatt.
| Funn | Kilde | Resultat |
|---|---|---|
| Gjenkjenningsrate | arXiv-studie, 12 500 deltakere | Rundt 62 %, like over gjettenivå (50 %) |
| Vanskelighetsgrad | Samme studie | Best på portretter, klart dårligere på natur- og bylandskap |
| Samlet vurdering | Association for Computing Machinery | “As Good as a Coin Toss” på tvers av flere studier |
| Effekt av trening | Northwestern Kellogg School | Merkbar forbedring etter kun 30 minutters målrettet opplæring |
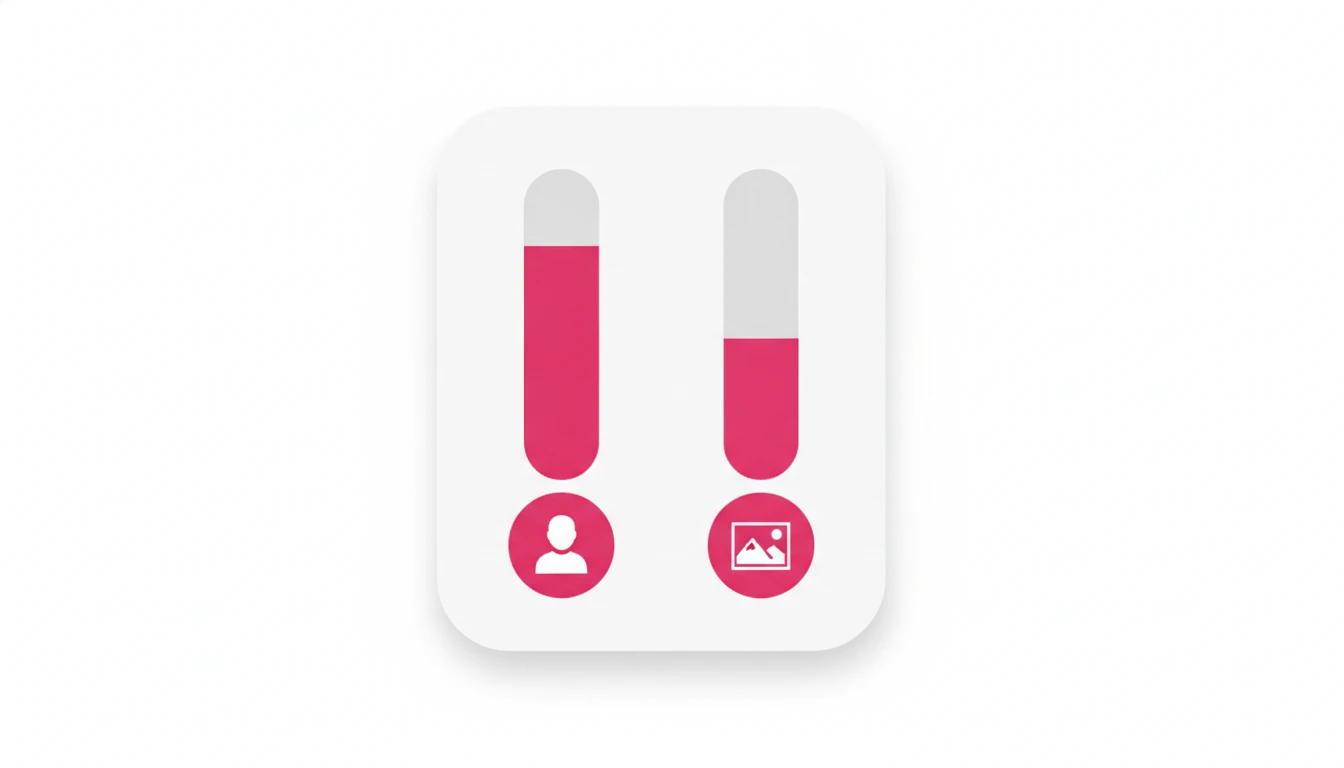
To fyllingsmålere viser forskjellen forskningen fant: langt høyere treffsikkerhet på portretter enn på natur- og bylandskap.
Hvorfor har dette blitt så vanskelig?
For bare et par år siden var de klassiske “tegnene” på et AI-bilde ganske pålitelige. Typiske eksempler var for mange fingre, unaturlig symmetriske ansikter, uleselig tekst og glatt eller voksaktig hud. De nyeste bildemodellene er trent til å rette nettopp disse svakhetene, ifølge en gjennomgang fra AI-forskeren og forfatteren Leon Furze. Derfor forsvinner de mest åpenbare feilene gradvis. Forskjellene som gjenstår, er langt mer subtile. Det gjelder for eksempel lysets fysikk, skarpheten i skygger og unaturlige mønstre i teksturer, og slike detaljer krever et mye mer trent blikk.
Det har blitt en form for våpenkappløp. Hver gang forskere og brukere finner et avslørende kjennetegn, et såkalt “tell”, trener utviklerne det bort i neste modellversjon. Derfor blir listen over pålitelige tegn stadig kortere og mer teknisk, samtidig som bildekvaliteten øker.
Hvilke tegn fungerer fortsatt best?
Ingen enkelttegn er vanntett lenger. Likevel peker forskningen og praktiske eksperimenter, som spillet Leon Furze omtaler, mot noen områder der sjansen din fortsatt er reell:
- Lys og skygger som ikke stemmer fysisk overens med hverandre i bildet, spesielt der flere lyskilder skulle møtes naturlig
- Bakgrunnsdetaljer langt fra hovedmotivet, som mønstre i tekstiler, arkitektur eller folkemengder, der modellen har mindre “oppmerksomhet” å bruke enn på hovedmotivet
- Håndverk og gjenstander med gjentakende, presise mønstre, som fortsatt kan bli subtilt feil selv i nyere modeller
- Konteksten rundt bildet, ikke bildet i seg selv: hvem publiserte det, når og finnes det andre, uavhengige kilder som viser samme hendelse eller motiv?
Etter hvert som selve bildeanalysen blir vanskeligere, har det siste punktet i praksis blitt det mest pålitelige verktøyet, ifølge flere av kildene i denne artikkelen. Kildekritikk slår altså pikselanalyse.
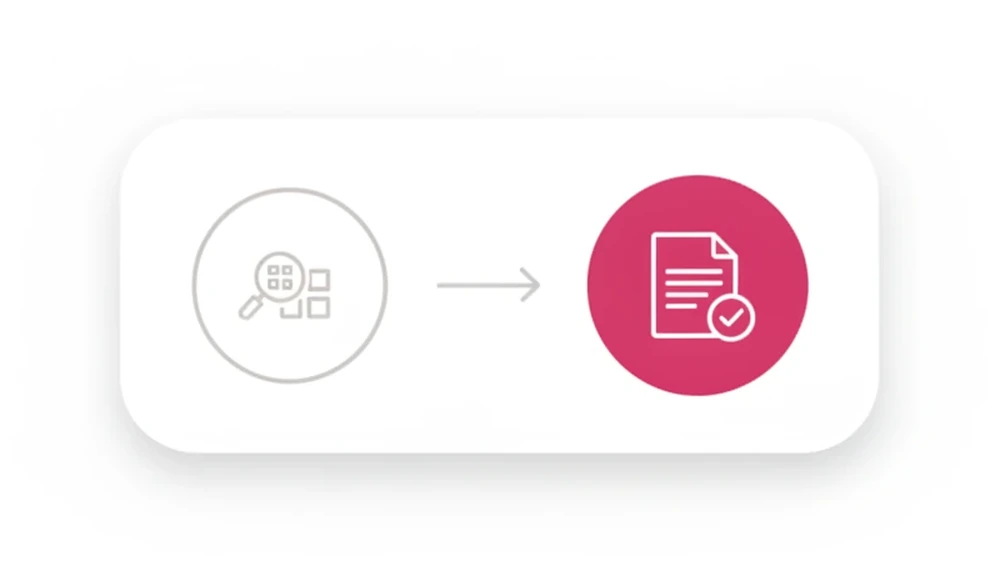
En pil viser skiftet i vekt: fra pikselanalyse i bildet til kildekritikk av hvem som publiserte det.
Vanlige spørsmål
Betyr dette at vannmerking (C2PA) løser problemet?
Ikke fullt ut. Denne artikkelen handler om hvor godt vi mennesker selv ser forskjell, uansett om bildet er merket eller om merkingen er bevart. Merkingsstandarden C2PA, og hvorfor den ikke er en fullstendig løsning alene, har AIFokus en egen artikkel om. Du finner den under «Se også» nederst.
Blir det umulig å se forskjell på ekte og AI-bilder i fremtiden?
For de fleste bildetyper tyder forskningen på en klar trend i den retningen. Likevel finnes det fortsatt kategorier der forskjellene er lettere å få øye på enn i andre, for eksempel visse typer landskap og gjentakende mønstre. Det viser studien med 12 500 deltakere.
Hjelper det å trene seg opp?
Ja. Selv en kort, målrettet opplæringsøkt ga en merkbar forbedring sammenlignet med ingen trening, ifølge forskning fra Northwestern University. Evnen er altså delvis en ferdighet du kan bygge opp, og ikke bare noe du enten har eller ikke har.
Oppsummering og kilder
Det viktigste å huske:
- En stor studie med over 12 500 deltakere fant en gjenkjenningsrate på rundt 62 prosent, nær gjettenivå
- Mennesker er klart bedre på portretter enn på natur- og bylandskap
- Klassiske tegn (fingre, symmetri, tekst) blir stadig mindre pålitelige etter hvert som modellene forbedres
- Kort, målrettet trening kan gi en reell forbedring i folks treffsikkerhet
- Kildekritikk (hvem publiserte det, finnes uavhengig bekreftelse) er blitt vel så viktig som selve bildeanalysen
Kilder brukt i denne artikkelen:
- ACM: As Good as a Coin Toss, Human Detection of AI-Generated Content
- arXiv: How good are humans at detecting AI-generated images? Learnings from an experiment
- Kellogg Insight, Northwestern University: To Spot AI Fakes, a Little Training Goes a Long Way
- Dr. Leon Furze: Can You Spot an AI Generated Image?
Sist oppdatert: August 2026
Se også: Hva er vannmerking av KI-innhold (C2PA), og løser det problemet med falske bilder? for den tekniske løsningen bransjen forsøker seg på, Kan du stole på det du leser? AI-generert nettinnhold («AI slop») forklart for det bredere bildet av KI-innhold på nett og Slik fungerer AI-bildegenerering, forklart uten fagspråk for selve teknologien bak bildene forskningen i denne artikkelen tester deg på.
Les også
Kan du stole på det du leser? AI-generert nettinnhold («AI slop») forklart
I gjennomsnitt brukte over én million YouTube-kanaler daglig plattformens egne KI-verktøy i desember 2025. Mye av det som fylles ut på nettet nå er billig, masseprodusert KI-innhold, kalt "AI slop". Her er hva det er, og hva det betyr for hvor mye du kan stole på det du leser.
Hva er en AI-avatar, og hvordan lages en digital tvilling av deg selv?
"Kan du forklare hva en AI-tvilling egentlig er?" spør stadig flere på nett. Verktøy som HeyGen og Synthesia kan lage en digital versjon av deg fra en kort videoopptak. Her er hva en AI-avatar faktisk er, hva den brukes til, og hvorfor samtykke er det springende punktet.
Kan en AI gjenskape noen som har dødd? Sørgeroboter forklart
En chatbot kan i dag lages til å "snakke" med stemmen eller skrivestilen til en avdød person. Forskere advarer mot mulighetene teknologien gir. Her er hva "sørgeroboter" faktisk er, hva de kan gjøre, og hva fagfolk sier om risikoen.