Hvordan trenes en AI-modell? Data, mønstre og algoritmer
Sist faktasjekket:
Kort oppsummert
AI-modeller trenes ved at de får enorme mengder eksempler og finner mønstre i dem selv, litt som når et barn lærer hva en katt er ved å se tusenvis av kattebilder. For hvert forsøk justerer modellen seg litt, og etter millioner av forsøk blir den god. Hvor god den blir, avhenger mest av kvaliteten på dataene den trenes på.
Hva betyr det å “trene” en AI?
Når vi sier at en AI-modell “trenes”, mener vi at den lærer fra eksempler. Det er grunnleggende annerledes enn tradisjonell programmering, der en utvikler skriver regler for hvert tilfelle.
Tradisjonell programmering: Utvikleren skriver: “Hvis bildet har fire ben, pels og sier mjau, er det en katt.”
Maskinlæring: Vi viser modellen millioner av bilder merket “katt” og “ikke katt”, og den finner selv ut hva som kjennetegner en katt.
Fordelen med maskinlæring er at modellen kan oppdage mønstre som er for komplekse til at mennesker klarer å formulere dem som regler. Ulempen er at vi trenger mye data, og at vi ikke alltid kan forklare nøyaktig hvorfor modellen tar de beslutningene den gjør.
Steg 1: Samle inn og forberede data
Alt starter med data, og du trenger mye av det. Hva slags data det er, avhenger av hva modellen skal lære.
For bildegjenkjenning: Her trenger modellen millioner av bilder med etiketter som beskriver hva som er på dem.
For språkmodeller som ChatGPT: Her trengs enorme mengder tekst fra internett, som bøker, artikler, nettsider og diskusjoner. OpenAI og andre selskaper bruker milliarder av tekster for å trene modellene sine.
Dataklargjøring: Før treningen kan starte, må dataene renses og struktureres. Det betyr å fjerne duplikater, rette feil og dele dataene i tre. Treningssettet er det modellen lærer fra, valideringssettet brukes til å justere underveis, og testsettet brukes til å evaluere modellen til slutt.
Kvaliteten på dataene er avgjørende. Inneholder dataene feil, fordommer eller mangler, lærer modellen nemlig de samme problemene.
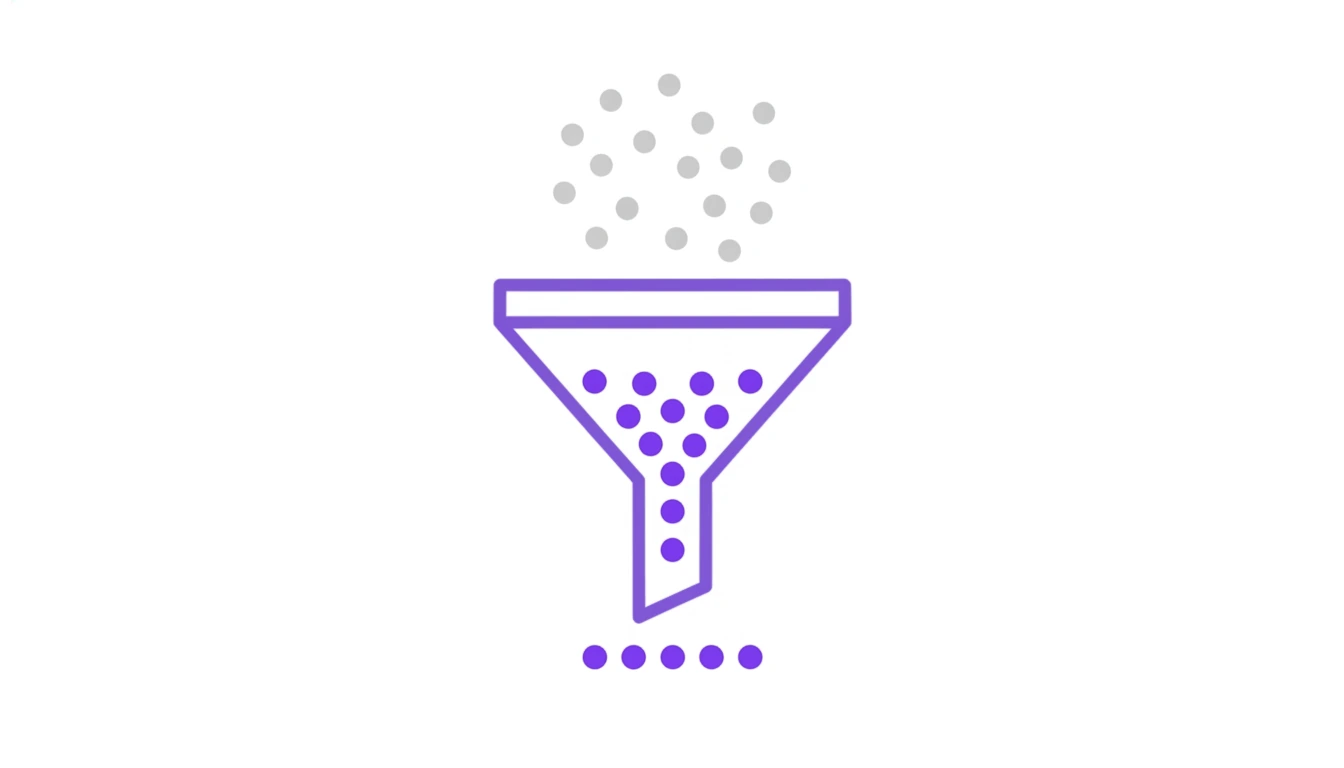 En trakt sorterer spredte grå prikker om til en ryddig rad fiolette prikker og viser hvordan rådata blir strukturert.
Steg 2: Velge og bygge modellen
En AI-modell er en matematisk struktur som kan lære mønstre. Innen dyp læring bruker man nevrale nettverk med mange lag.
Før treningen må utviklerne bestemme hvordan nettverket skal se ut. Det kalles arkitekturen, og den bestemmer hvor mange lag det skal være, hvor mange “nevroner” hvert lag har, og hvordan lagene er koblet sammen. Språkmodeller som ChatGPT bruker en arkitektur som kalles “transformer”.
Hvilken arkitektur som passer, avhenger av oppgaven. Noen er bedre for bilder, andre for tekst og andre for lyd.
Når modellen er bygget, har den mange justerbare verdier som kalles “parametere”. Det er de som bestemmer hvordan modellen oppfører seg, og moderne AI-modeller kan ha milliarder av dem. OpenAI har aldri bekreftet et offisielt tall for GPT-4, men uavhengige anslag ligger på rundt 1,8 billioner parametere (the-decoder.com).
Steg 3: Selve treningen
Selve treningen er en løkke som gjentas om og om igjen. Forenklet ser den slik ut:
1. Modellen ser et eksempel: Den får for eksempel se et bilde merket “katt”.
2. Modellen gjetter: Ut fra parameterne den har nå, gjetter modellen hva bildet viser.
3. Feilen beregnes: Så måles det hvor langt unna riktig svar gjetningen var.
4. Parameterne justeres: Deretter justerer modellen de interne verdiene sine litt, slik at den gjør færre feil neste gang.
5. Gjenta millioner av ganger: Dette gjentas for hvert eksempel i treningsdataene, og ofte går modellen gjennom hele datasettet mange ganger. Hver slik runde kalles en epoke.
 En pil går fra en skjelvende, stiplet linje til en solid fiolett pil og viser hvordan modellen korrigerer til den treffer.
Slik blir modellen litt bedre for hver runde, omtrent som når du øver på et musikkinstrument. Det er de tusenvis av repetisjonene som gjør deg god.
Maskinvare og ressurser
Å trene store AI-modeller krever enorme ressurser.
GPU-er og TPU-er: Dette er spesialiserte prosessorer som kan gjøre mange beregninger samtidig. Et stort treningsprosjekt kan bruke tusenvis av dem.
Tid: Selv med kraftig maskinvare kan det ta uker eller måneder å trene en stor språkmodell.
Energi: AI-trening bruker mye strøm. Treningen av GPT-3 brukte rundt 1287 megawattimer, tilsvarende strømforbruket til omtrent 120 amerikanske husstander i ett år (Wharton: The Hidden Cost of AI Energy Consumption).
Kostnad: Treningen av GPT-4 kostet over 100 millioner dollar, altså opp mot en milliard kroner (Wired).
Fordi kravene er så store, er det bare store selskaper og forskningsinstitusjoner som kan trene de største modellene fra bunnen av.
 Tre fiolette ikonmerker med en brikke, en klokke og et lyn viser maskinvaren, tiden og energien AI-trening krever.
Finjustering og tilpasning
Når grunntreningen er ferdig, kan modellen finjusteres til bestemte oppgaver.
Finjustering (fine-tuning): Man tar en ferdigtrent modell og trener den videre på spesialiserte data. En generell språkmodell kan for eksempel finjusteres til å bli bedre på medisinsk tekst.
RLHF (Reinforcement Learning from Human Feedback): Mennesker vurderer svarene modellen gir, og modellen lærer å gi de svarene de foretrekker. Det var slik ChatGPT ble gjort mer nyttig og trygg.
Finjustering er mye billigere enn å trene fra bunnen av. Derfor kan også mindre organisasjoner tilpasse eksisterende modeller til sine egne behov.
Vanlige spørsmål
Hvor mye data trengs for å trene en AI?
Det varierer enormt. En enkel modell kan trenes på tusenvis av eksempler, mens store språkmodeller trenes på billioner av ord.
Kan jeg trene min egen AI?
Ja, hvis det er snakk om enkle modeller. Mange verktøy gjør det mulig å eksperimentere med maskinlæring på egen hånd. Store modeller er en annen sak, for de krever ressurser de fleste ikke har.
Hvorfor gjør AI noen ganger feil?
Fordi modellen bare har lært mønstre fra treningsdataene. Møter den noe som er veldig annerledes, eller var treningsdataene mangelfulle, kan den ta feil.
Fortsetter modeller å lære etter trening?
Nei, de fleste modeller er “frosset” etter treningen. ChatGPT lærer ikke av samtalene du har med den, med mindre en egen funksjon for det er slått på.
Oppsummering og kilder
Det viktigste å huske er at AI lærer fra eksempler, ikke fra regler som noen har programmert. Derfor bestemmer kvaliteten på treningsdataene kvaliteten på modellen. Å trene store modeller krever enorme ressurser, men med finjustering kan eksisterende modeller tilpasses nye oppgaver langt billigere.
Kilder: Google AI: Machine Learning, OpenAI, IBM: How AI Works, the-decoder.com: GPT-4 architecture leaked, Wired: The Age of Giant AI Models Is Already Over, Wharton: The Hidden Cost of AI Energy Consumption
Sist oppdatert: Januar 2026
Les også
Forskjellen på kunstig intelligens, maskinlæring og dyp læring
Hva er egentlig forskjellen på AI, maskinlæring og dyp læring? Denne guiden forklarer de tre begrepene enkelt, med eksempler og sammenligningstabeller.
Hva er maskinlæring? Enkelt forklart med eksempler
Lær hva maskinlæring er, hvordan det fungerer, og se praktiske eksempler. Vi forklarer supervised, unsupervised og reinforcement learning på en enkel måte.
Typer maskinlæring: Supervised, unsupervised og reinforcement learning forklart
Hva er forskjellen på overvåket læring, uovervåket læring og forsterkningslæring? Lær hvordan hver metode fungerer med praktiske eksempler.