Hva er nevrale nettverk? En enkel forklaring
Sist faktasjekket:
Kort oppsummert
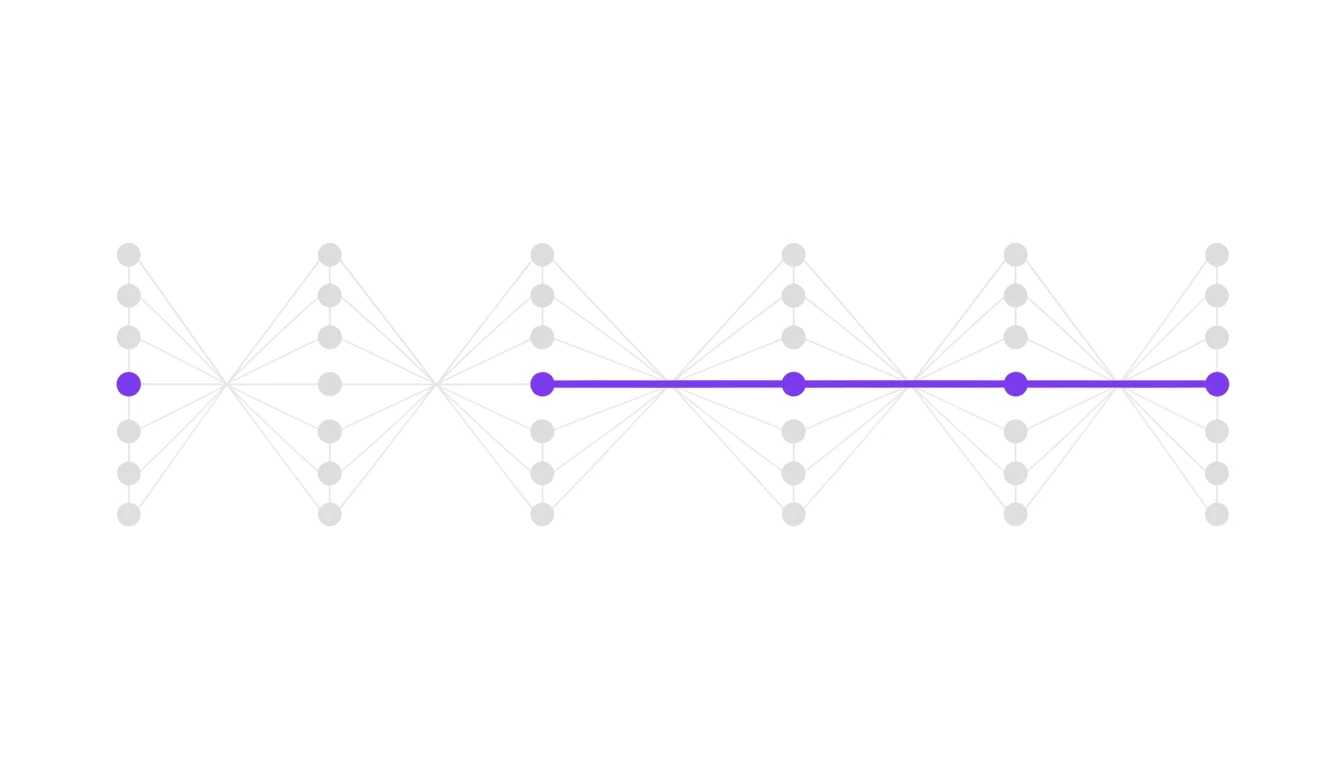
Nevrale nettverk, eller neural networks på engelsk, er dataprogrammer som er løst inspirert av hjernen vår. De består av mange små enheter, såkalte “kunstige nevroner”, som er koblet sammen i lag og bearbeider data lag for lag. Det er denne teknologien som gjør at datamaskiner kan kjenne igjen bilder, forstå tale og skrive tekst, slik ChatGPT gjør.
Hva er et neural network?
Når du hører om artificial intelligence og machine learning, dukker ofte begrepet “neural networks” opp. Det høres kanskje komplisert ut, men grunnideen er faktisk ganske enkel å forstå.
Et neural network (nevralt nettverk) er en type dataprogram som er inspirert av hvordan hjernen vår fungerer. Hjernen din har omtrent 86 milliarder hjerneceller, som kalles nevroner. De er koblet sammen og sender signaler til hverandre. Kunstige neural networks har også sammenkoblede enheter, men langt færre og mye enklere.
Hjernen din lærer ved at forbindelsene mellom hjernecellene blir sterkere jo mer de brukes. Et neural network gjør noe lignende når det justerer styrken på forbindelsene sine for å bli bedre til oppgaven det trenes på.
Hvordan er et neural network bygget opp?
Et neural network består av tre hovedtyper lag:
1. Input layer (inngangslaget)
Her kommer dataene inn. Skal nettverket kjenne igjen et bilde, blir hver piksel i bildet en egen input, så et lite bilde på 100x100 piksler gir hele 10 000 inputs!
2. Hidden layers (skjulte lag)
Dette er lagene i midten, der selve “tenkningen” skjer. De kalles “skjulte” fordi vi bare ser det som kommer inn og det som kommer ut, ikke det som skjer i dem. Jo flere hidden layers, desto “dypere” er nettverket, og det er derfor det heter deep learning.
3. Output layer (utgangslaget)
Her kommer svaret ut. Skal nettverket avgjøre om et bilde viser en hund eller en katt, kan output layer ha to enheter, én for “hund” og én for “katt”. Den enheten som får høyest verdi, er svaret.
Hvordan lærer et neural network?
Si at vi vil lære et neural network å skille mellom bilder av katter og hunder. Da foregår det omtrent slik:
Trinn 1: Start med tilfeldige gjettninger I begynnelsen vet ikke nettverket noe, så det gjetter tilfeldig om hvert bilde viser en hund eller en katt.
Trinn 2: Sjekk om gjettningen var riktig For hvert bilde sammenligner vi gjetningen med det riktige svaret. Viste bildet en katt mens nettverket gjettet hund, var svaret feil.
Trinn 3: Juster forbindelsene Nå justerer nettverket styrken på forbindelsene sine for å gjøre færre feil neste gang. Forbindelser som bidro til riktige svar, blir sterkere, mens forbindelser som bidro til feil svar, blir svakere.
Trinn 4: Gjenta tusenvis av ganger Når dette gjentas om og om igjen med tusenvis av bilder, blir nettverket gradvis bedre. Etter nok trening kan det kjenne igjen katter og hunder det aldri har sett før.
 En sirkelformet pil i fiolett viser hvordan en forbindelse blir tykkere og sterkere for hver runde med gjentatt trening.
IBM forklarer at denne prosessen kalles backpropagation. Feilinformasjonen sendes altså bakover gjennom nettverket, slik at alle forbindelsene kan justeres.
Hva brukes neural networks til?
Neural networks står bak mye av den AI-teknologien vi bruker i hverdagen:
Bildegjenkjenning
Det er neural networks som gjør at telefonen din kan sortere bilder etter hvem som er på dem, og at sosiale medier automatisk foreslår hvem du skal tagge. Google Photos bruker for eksempel neural networks til å organisere bildene dine.
Språk og tekst
ChatGPT, Google Translate og alle andre AI-verktøy som jobber med tekst, bruker avanserte neural networks. De har lært fra enorme mengder tekst, og derfor kan de nå gi sammenhengende svar.
Tale og stemme
Siri, Alexa og Google Assistant bruker neural networks til å forstå hva du sier. Først gjøres lydbølgene om til tekst, og så finner et annet nettverk ut hva du mente.
Anbefalingssystemer
Netflix, Spotify og YouTube bruker neural networks til å finne ut hva du sannsynligvis vil like, ut fra det du har sett eller hørt før.
 Fire ikonmerker i fiolett viser bruksområder for nevrale nettverk: bilder, tekst, tale og anbefalinger.
Neural networks vs. den menneskelige hjernen
Det er fristende å sammenligne neural networks med hjernen, men det er viktig å forstå forskjellene:
| Menneskelig hjerne | Neural networks |
|---|---|
| ~86 milliarder nevroner | Millioner til milliarder parametere |
| Bruker ca. 20 watt strøm | Kan bruke tusenvis av watt |
| Lærer fra få eksempler | Trenger ofte millioner av eksempler |
| Kan generalisere til helt nye situasjoner | Sliter med situasjoner utenfor treningsdata |
| Har bevissthet og forståelse | Ingen bevissthet, bare mønstergjenkjenning |
Den viktigste forskjellen er at du FORSTÅR at dette er en artikkel om neural networks. Et neural network som analyserer den samme teksten, forstår ingenting av den. Det kjenner bare igjen mønstre i bokstavene og ordene.
Forskjellige typer neural networks
Forskere har utviklet ulike typer nettverk for ulike oppgaver:
CNN (Convolutional Neural Networks): Disse er best til bilder, fordi de er laget for å kjenne igjen mønstre som kanter, former og objekter.
RNN (Recurrent Neural Networks): Disse er laget for sekvenser som tekst eller tale, der rekkefølgen er viktig.
Transformers: Dette er den nyeste og mest kraftfulle typen, og den brukes av ChatGPT og lignende verktøy. Transformers kan analysere hele tekster på én gang og er svært gode på språk.
Du trenger ikke huske disse navnene, men det er nyttig å vite at ulike oppgaver bruker ulike typer nettverk.
 Tre ikonmerker i fiolett viser ulike typer nevrale nettverk: et rutenett, en pil i en sløyfe og et forgrenet mønster.
Vanlige spørsmål
Tenker neural networks som mennesker?
Nei. Selv om de er inspirert av hjernen, fungerer de veldig annerledes. De har ingen bevissthet, følelser eller ekte forståelse. De er gode til å finne mønstre i data, men de “tenker” ikke i noen meningsfull forstand.
Kan hvem som helst lage et neural network?
Med moderne verktøy er det enklere enn noen gang, for biblioteker som TensorFlow og PyTorch har gjort det tilgjengelig for folk som kan litt programmering. Men for å lage virkelig gode nettverk trengs mye erfaring og kunnskap.
Hvorfor trenger neural networks så mye data?
Fordi de lærer fra eksempler, og jo flere eksempler de får, desto bedre kan de generalisere til nye situasjoner. Viser du nettverket bare 10 bilder av katter, vil det slite med å kjenne igjen katter som ser annerledes ut enn de 10 det har sett.
Hva er forskjellen på neural networks og deep learning?
Deep learning er bruk av neural networks med mange hidden layers. Alle deep learning-systemer bruker neural networks, men et neural network med bare ett eller to lag kalles ikke “deep” learning.
Oppsummering og kilder
Det viktigste å huske:
- De består av input layer, hidden layers og output layer
- De lærer ved å justere forbindelser basert på tilbakemelding (backpropagation)
- De er bak det meste av AI vi bruker i dag
- De er mye enklere enn hjernen og har ingen bevissthet
Kilder:
Sist oppdatert: Januar 2026
Les også
Forskjellen på kunstig intelligens, maskinlæring og dyp læring
Hva er egentlig forskjellen på AI, maskinlæring og dyp læring? Denne guiden forklarer de tre begrepene enkelt, med eksempler og sammenligningstabeller.
Hva er dyp læring? Nevrale nettverk forklart enkelt
Lær hva dyp læring er, hvordan nevrale nettverk fungerer, og hvorfor denne teknologien driver ChatGPT, bildegjenkjenning og moderne AI.
Historien om kunstig intelligens: Hvem oppfant AI og når?
En reise tilbake til 1950-tallet som forklarer hvordan Alan Turing og forskere på Dartmouth-konferansen grunnla kunstig intelligens som fagfelt.