Hva er multimodal AI? Modeller som forstår tekst, bilde og lyd
Sist faktasjekket:
Kort oppsummert
Multimodal AI er kunstig intelligens som kan forstå og jobbe med flere typer informasjon samtidig, som tekst, bilder, lyd og video. ChatGPT, Google Gemini og Claude er eksempler på multimodale modeller. De kan for eksempel se på et bilde og beskrive hva som er på det, eller analysere en video.
Hva betyr “multimodal”?
Ordet “multimodal” kommer fra “multi” (mange) og “modal” (måte/form). I AI-sammenheng betyr det at systemet kan jobbe med flere typer data samtidig.
Tenk på hvordan du selv opplever verden. Du ser bilder, hører lyder og leser tekst, og hjernen din setter alt sammen til én samlet forståelse. Tradisjonell AI har vært mer som separate sanser som ikke snakker sammen, med én AI for tekst og en annen for bilder. Multimodal AI er mer som en hjerne som kombinerer alle sansene på én gang.
Nå kan du for eksempel vise AI-en et diagram og be den forklare hva det betyr, eller laste opp en video og be om en oppsummering. Du kan også ta et bilde av kjøleskapet ditt og spørre “Hva kan jeg lage til middag med dette?”
Google DeepMind har utviklet Gemini, som er bygget for å være multimodal helt fra starten av. Modellen “tenker” altså i tekst, bilde og lyd samtidig.
Hvordan fungerer multimodal AI?
Et enkelt eksempel gjør det tydeligere. Tenk deg at du viser AI-en et bilde av en hund som leker i en park, og spør “Hva skjer på dette bildet?”
Tradisjonell AI (ikke multimodal): Én AI analyserer bildet og sier kanskje “hund, gress, ball”, mens en helt annen AI tar seg av tekstspørsmålet ditt. De to systemene snakker ikke sammen.
Multimodal AI: Samme system ser bildet OG forstår spørsmålet ditt. Det kombinerer informasjonen og svarer: “Bildet viser en golden retriever som leker med en rød ball i en grønn park. Det ser ut som en fin sommerdag.”
Teknisk sett fungerer det ved at AI-en gjør om alle typer data til et felles “språk” internt. Bilder, tekst og lyd blir altså til tall som modellen kan jobbe med samlet.
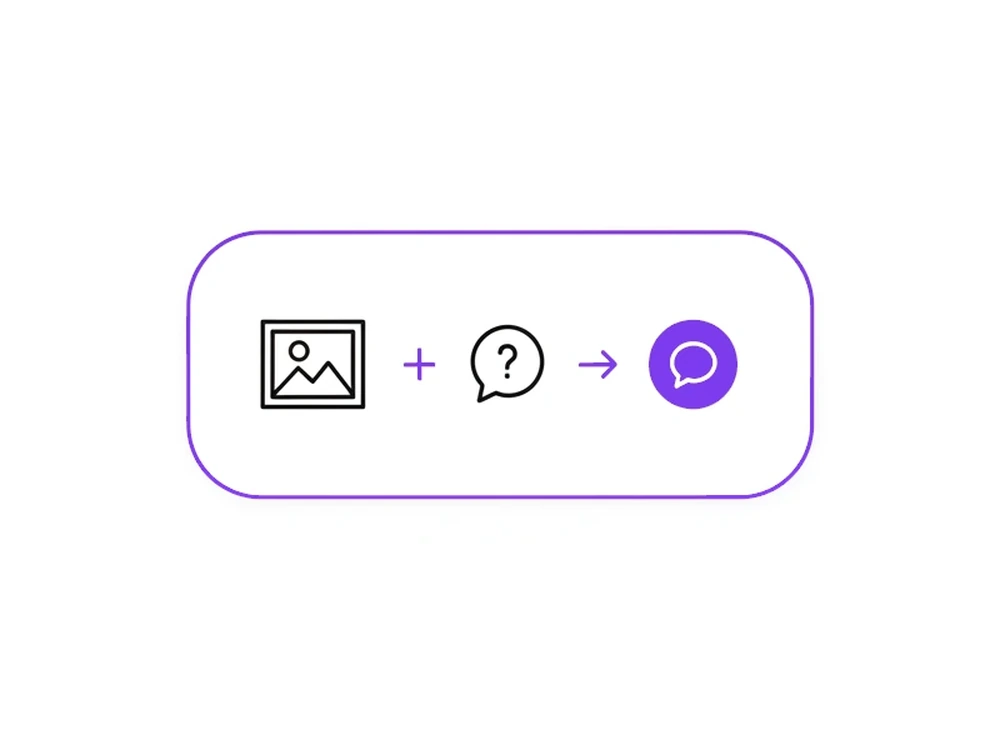 Multimodal AI kombinerer et bilde og et spørsmål i ett system og gir ett samlet svar i stedet for to atskilte resultater.
Eksempler på multimodal AI i praksis
ChatGPT (OpenAI): Du kan laste opp bilder i ChatGPT og stille spørsmål om dem. Du kan for eksempel ta bilde av en plante og spørre hva slags plante det er, eller vise den et skjermbilde og be om hjelp.
Google Gemini: Gemini er laget for å være multimodal helt fra bunnen av. Derfor kan den analysere tekst, bilder, lyd og video i samme samtale.
Claude (Anthropic): Claude kan også analysere bilder og dokumenter og kombinere dem med tekstsamtalen.
Du har nytte av dette både på skolen, på jobben og i hverdagen. Elever kan ta bilde av en matteoppgave og få en steg-for-steg-forklaring, og på jobben kan AI-en analysere grafer og diagrammer i rapporter. I hverdagen kan du finne ut hva en plante heter, få oppskriftsforslag fra et bilde av ingrediensene eller oversette tekst på skilt.
 Et bilde av en plante gir modellen nok informasjon til å foreslå riktig art, uten at du selv beskriver bladene i tekst.
Hvorfor er dette en stor forbedring?
Før multimodal AI måtte du beskrive alt med ord. Ville du ha hjelp med et bilde, måtte du først beskrive det i detalj, og det var både tungvint og ofte unøyaktig.
Nå kan du bare vise bildet direkte. Det går raskere når du slipper den lange beskrivelsen, og det blir mer nøyaktig fordi AI-en ser det samme som deg. Dessuten er det mer naturlig, siden det ligner på hvordan mennesker kommuniserer.
Multimodal AI åpner for helt nye bruksområder som ikke var mulige før, ifølge OpenAI sin forskning på GPT-4. Det er et betydelig steg fremover for hvordan vi kan samhandle med AI-systemer.
Begrensninger å være klar over
Multimodal AI er imponerende, men ikke perfekt.
Kan feiltolke bilder: Akkurat som med tekst kan AI-en misforstå hva den ser, så dobbeltsjekk viktige tolkninger.
Sliter med dårlig bildekvalitet: Uklare, mørke eller forvirrende bilder gir dårligere resultater.
Personvernhensyn: Når du laster opp bilder, kan du komme til å dele personlig informasjon. Derfor bør du tenke over hva du deler med AI-tjenester, slik Datatilsynet anbefaler.
Tekst i bilder: Noen modeller sliter fortsatt med å lese håndskrift eller tekst i kompliserte bilder.
 Uklare eller mørke bilder gir modellen dårligere grunnlag, og resultatet kan bli en feiltolkning.
Fremtiden for multimodal AI
Multimodal AI utvikler seg raskt, og fremtidige systemer vil sannsynligvis kunne håndtere enda flere typer data samtidig. De vil trolig også forstå video i sanntid og gi svar som tar mer hensyn til sammenhengen.
Allerede nå jobber selskaper som Google og OpenAI med modeller som kan se, høre og snakke naturlig. Det kan gi AI-assistenter som føles mer som å snakke med en person som forstår hele situasjonen din, ikke bare ordene du skriver.
Vanlige spørsmål
Kan multimodal AI se video?
Ja, noen modeller kan analysere video, så du kan for eksempel laste opp en kort video og be om en oppsummering. Teknologien er fortsatt ganske ny, men den blir stadig bedre.
Er det gratis å bruke?
Bildeopplasting er tilgjengelig også i gratisversjonen av ChatGPT i dag, med et daglig tak på antall bilder, mens Gemini har gratis bildefunksjoner. Gratisversjonene har likevel ofte begrensninger.
Kan AI-en se alt jeg viser den?
Ja, AI-en analyserer hele bildet. Pass derfor på at det ikke er sensitiv informasjon synlig i bildene du laster opp.
Hva er forskjellen på multimodal og vanlig ChatGPT?
Den vanlige tekstversjonen av ChatGPT kan bare lese og skrive tekst. Den multimodale versjonen kan i tillegg “se” bilder du laster opp, og svare ut fra dem.
Oppsummering
Det viktigste å huske er at “multimodal” betyr at AI-en kan bruke flere “sanser”, så du kan vise et bilde i stedet for å beskrive det. Men vær forsiktig med personlig informasjon i bildene du laster opp.
Kilder
Sist oppdatert: Januar 2026
Les også
Forskjellen på kunstig intelligens, maskinlæring og dyp læring
Hva er egentlig forskjellen på AI, maskinlæring og dyp læring? Denne guiden forklarer de tre begrepene enkelt, med eksempler og sammenligningstabeller.
Historien om kunstig intelligens: Hvem oppfant AI og når?
En reise tilbake til 1950-tallet som forklarer hvordan Alan Turing og forskere på Dartmouth-konferansen grunnla kunstig intelligens som fagfelt.
Hva er kunstig generell intelligens (AGI)? Fremtidsvisjonen forklart
AGI er fremtidsvisjonen om maskiner som kan løse oppgaver på menneskelig nivå. Lær hva AGI er, hvor langt vi er kommet, og hvilke utfordringer som gjenstår.