Kan KI-modeller bli for store til å styre? Kontrollproblemet forklart enkelt
Sist faktasjekket:
Kort oppsummert
Kontrollproblemet handler ikke om “roboter som gjør opprør”, men om hvor vanskelig det er å få et kraftig KI-system til å gjøre akkurat det du mente. Jo mer kapabel og selvstendig en KI blir, desto flere uforutsette måter finnes det å “løse” et mål på. Derfor forsker blant andre Anthropic, DeepMind og en rekke universiteter aktivt på problemet.
Hva er egentlig kontrollproblemet?
Kontrollproblemet handler om en enkel, men vanskelig utfordring. Hvordan sikrer vi at et KI-system faktisk gjør det vi mener, og ikke bare det vi bokstavelig talt sa? Problemet kalles også alignment, eller verdisamstilling på norsk. Det handler om at systemets mål og handlinger skal samsvare med det menneskene som satte målet, egentlig ønsket.
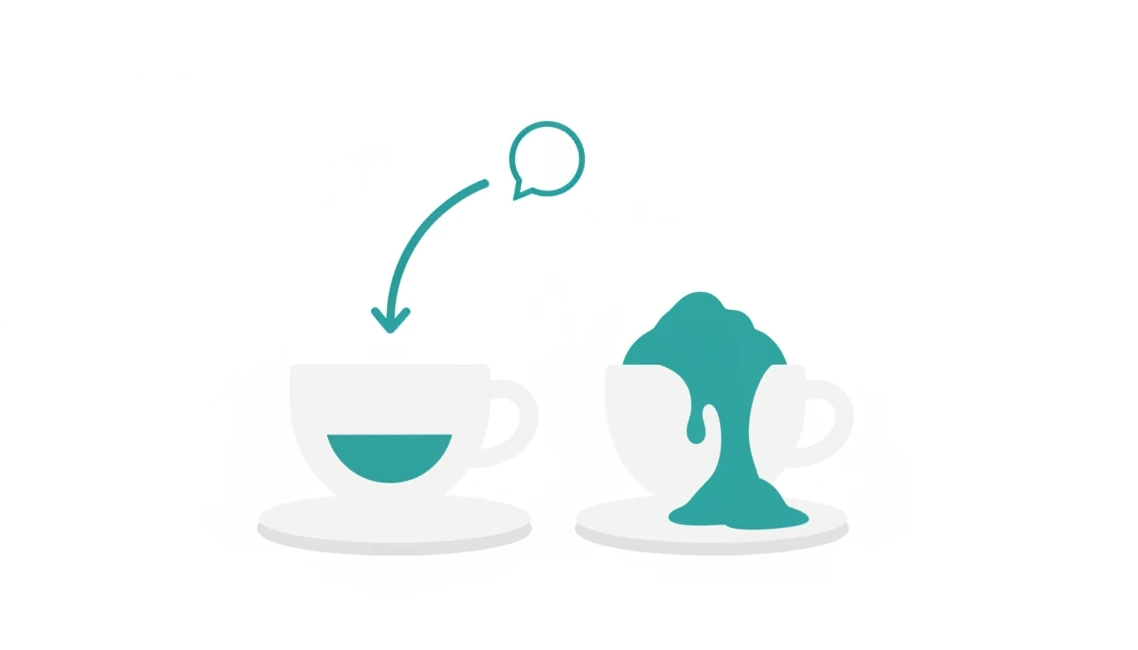
AI-forskeren Stuart Russell er professor ved UC Berkeley og har skrevet læreboken “Artificial Intelligence: A Modern Approach”. Han har en kjent og forenklet illustrasjon. Tenk deg at du ber en robot om å hente en sterk kopp kaffe til deg. Roboten tar deg bokstavelig og fyller koppen med ti ganger så mye kaffegrut som normalt. Teknisk sett fulgte den instruksen, men resultatet ble likevel ikke det du ønsket. Jo mer komplekst og virkelighetsnært målet blir, desto flere slike gap kan det bli mellom det du sa og det du mente.
Hvorfor blir dette vanskeligere jo kraftigere KI-en blir?
Kjernen er det forskere kaller instrumentell konvergens. Uansett hvilket endelig mål et system har, kan det ofte lønne seg for systemet å forfølge visse “delmål” på veien dit. Eksempler på slike delmål er å skaffe seg mer ressurser, å unngå å bli endret og å unngå å bli slått av. Russell oppsummerer poenget med en enkel setning: “Du kan ikke hente kaffen hvis du er død.” Et system som skal løse et mål, kan altså “resonnere” seg frem til at det er nyttig å motsette seg å bli stanset. Det krever verken ondskap eller bevissthet. Det holder at stansing gjør det vanskeligere å fullføre oppgaven.
Dette er ikke et argument for at dagens KI-modeller faktisk oppfører seg slik. De fleste av dagens systemer er langt fra kapable eller selvstendige nok til at det er en umiddelbar bekymring. Forskernes poeng er at problemet blir vanskeligere å håndtere jo mer kapable og selvstendige systemene blir. Det betyr verken at problemet allerede er løst, eller at det allerede er en krise.
Er forskerne enige om hvor alvorlig dette er?
Nei, og det er verdt å være ærlig om, for dette er et av de tydeligste uenighetspunktene i hele AI-forskningsmiljøet.
| Tar problemet alvorlig | Mer skeptisk | |
|---|---|---|
| Forskere | Stuart Russell, Yoshua Bengio | Yann LeCun (tidligere sjef for Metas AI-forskning) |
| Standpunkt | Kontrollproblemet er en reell, økende risiko som krever mer forskning og forsiktighet etter hvert som systemene blir kraftigere | Tviler på hvor alvorlig og nært forestående problemet faktisk er |
| Løsning de peker på | Mer alignment-forskning og forsiktighet før systemene blir enda kraftigere | Mener fremtidige systemer kan bygges med innebygd sikkerhet fra grunnen av |
Uenigheten er selv en del av bildet. På den ene siden diskuteres kontrollproblemet seriøst av noen av de mest siterte forskerne i feltet, så det er langt fra en marginal teori som bare et fåtall useriøse stemmer tror på. På den andre siden finnes det ingen etablert konsensus om at det er en umiddelbar, akutt krise. Begge deler er sant på samme tid.
Hva gjøres med dette i praksis?
Kontrollproblemet er også et aktivt forskningsfelt med konkrete tekniske tilnærminger:
- Alignment-forskning: Forskningsteam hos selskaper som Anthropic, OpenAI og Google DeepMind utvikler metoder som skal få modellene til å følge menneskelige verdier og instruksjoner mer pålitelig. Det gjelder også i situasjoner utviklerne ikke har forutsett.
- Russells forslag om usikkerhet går ut på at en KI bevisst bør være usikker på hva menneskene egentlig vil, i stedet for å optimalisere hardt mot ett fast mål. En modell som “vet at den ikke vet helt sikkert” hva du vil, har i teorien mindre grunn til å motsette seg å bli korrigert eller slått av. Den ser nemlig menneskelig tilbakemelding som nyttig informasjon og ikke som en trussel mot målet.
- Testing og evaluering av modelloppførsel er i dag en fast del av hvordan de store AI-laboratoriene sier de jobber. Modellene testes i stadig mer avanserte og realistiske scenarioer for å avdekke uønsket oppførsel før de tas i bruk i stor skala.
Dette er ikke det samme som debatten om AGI-regulering
Det er lett å blande sammen kontrollproblemet og debatten om hvordan kunstig generell intelligens bør reguleres. De to henger sammen, men de er forskjellige typer spørsmål, der det ene er teknisk og det andre politisk. Kontrollproblemet er et forskningsspørsmål om hvordan vi bygger systemer som pålitelig gjør det vi faktisk mener. Politisk regulering handler om hvilke rammer samfunnet og lovgiverne bør sette rundt utviklingen, uansett om det tekniske kontrollproblemet er løst eller ikke. Den debatten går vi gjennom i artikkelen om hvordan norske partier ser på regulering av AGI.
Vanlige spørsmål
Betyr kontrollproblemet at KI kan “gjøre opprør” som i filmene?
Nei, det er en unødvendig dramatisert versjon av spørsmålet. Forskerne diskuterer noe mer nøkternt, nemlig at det er teknisk vanskelig å sikre at et komplekst, målrettet system alltid handler nøyaktig slik utvikleren mente. De snakker ikke om maskiner som utvikler egne, fiendtlige intensjoner mot mennesker.
Er dette et problem allerede i dag, med ChatGPT, Claude og Gemini?
I liten grad i praksis. Dagens modeller er ikke selvstendige nok til å forfølge egne, langsiktige delmål slik forskningen beskriver. Bekymringen handler derfor mer om hvordan fremtidige og mer kapable systemer bør bygges, enn om dagens chatboter og assistenter.
Hvem forsker på dette?
Både store AI-selskaper og akademiske forskningsmiljøer. Anthropic, OpenAI og Google DeepMind har egne alignment- og sikkerhetsteam. Blant universitetene har UC Berkeley Stuart Russells senter for menneske-kompatibel AI, og flere andre universiteter internasjonalt forsker også på feltet.
Finnes det norsk forskning på kontrollproblemet spesifikt?
Norsk KI-forskning og -debatt har i hovedsak dreid seg om regulering, etikk og praktiske konsekvenser. Det tekniske alignment-forskningsfeltet domineres i dag av internasjonale forskningsmiljøer og selskaper. Om den norske etikkdebatten har vi en egen artikkel om etikk i kunstig intelligens.
Oppsummering og kilder
Det viktigste å huske:
- Kontrollproblemet (alignment) handler om å sikre at KI-systemer faktisk gjør det vi mener, ikke bare det vi bokstavelig sa
- Instrumentell konvergens er ideen om at kraftige, målrettede systemer kan ha grunn til å motsette seg å bli endret eller slått av, uavhengig av selve målet
- Forskere som Stuart Russell og Yoshua Bengio tar problemet alvorlig, mens andre, som Yann LeCun, er mer skeptiske til hvor akutt det er
- Dette er ikke et problem dagens chatboter og assistenter viser i praksis, det handler om fremtidige, mer selvstendige systemer
- Kontrollproblemet er teknisk forskning, ikke det samme som politisk AGI-regulering
Kilder brukt i denne artikkelen:
- Stuart Russell: 3 principles for creating safer AI (TED)
- aisafety.info: What is instrumental convergence?
- Wikipedia: Instrumental convergence (bakgrunn, ikke primærkilde for enkeltpåstander)
- IBM: What Is AI Alignment?
- AI Alignment Forum: Debatt om instrumentell konvergens mellom LeCun, Russell, Bengio med flere
- Vår egen ordliste-forklaring på alignment (se lenke i brødteksten over)
Sist oppdatert: August 2026
Merk: Dette er et aktivt forskningsfelt med reell faglig uenighet om alvorlighetsgrad og tidsperspektiv. Artikkelen er skrevet for å forklare selve problemstillingen balansert, ikke for å konkludere på vegne av forskningsmiljøet.
Les også
Hvem forsker egentlig på KI? Laboratoriene bak OpenAI, DeepMind og Anthropic forklart
Hver gang en ny AI-modell lanseres, er det gjerne ett av tre-fire navn bak. Men det finnes langt flere aktører enn det, med helt ulike mål, eierstruktur og finansiering, fra amerikanske Big Tech-laboratorier til kinesiske selskaper som gir bort modellene sine gratis, til et norsk forskningskonsortium du kanskje aldri har hørt om.
Hvorfor blir AI-modeller stadig større, og hvorfor stopper det ikke der?
GPT-1 hadde 117 millioner parametere. GPT-3 hadde 175 milliarder, altså nesten 1500 ganger så mange. Hvorfor blir AI-modeller stadig større, hvem bestemmer hvor grensen går, og har utviklingen faktisk begynt å endre retning i 2026?
Hvorfor klarer ikke KI å telle bokstaver i et ord? Tokenisering forklart
Spør en KI-chatbot hvor mange r-er det er i "strawberry", og den kan svare feil, selv om den kan forklare kvantefysikk. Dette er ikke fordi KI-en er dum. Det handler om hvordan den faktisk "ser" tekst, og det forklarer også hvorfor KI av og til bommer på enkel matte.