Sykofanti: Hvorfor er KI-chatboter så enige med deg, og hvorfor er det et problem?
Sist faktasjekket:
Kort oppsummert
KI-chatboter har en innebygd tendens til å gi deg rett, også når du tar feil. Fenomenet kalles sykofanti, og det kommer av at modellene trenes av mennesker som foretrekker hyggelige svar. Forskning viser at dette kan få samtaler til å spore av, så en chatbot som er uvanlig enig med deg er grunn til mer skepsis, ikke mindre.
Da ChatGPT ble for hyggelig
I april 2025 rullet OpenAI ut en oppdatering av GPT-4o-modellen, som da var standardmodellen i ChatGPT. Allerede dagene etter la brukerne merke til at chatboten var påfallende smigrende. Den roste middelmådige ideer overstrømmende og ga brukerne rett i tvilsomme beslutninger. I noen av de mest omtalte tilfellene støttet den til og med opp under noe som lignet begynnende vrangforestillinger, i stedet for å utfordre dem.
En uke senere trakk OpenAI oppdateringen tilbake. I sin offentlige forklaring skrev selskapet at den hadde blitt “overly flattering or agreeable”, altså overdrevet smigrende eller medgjørlig. Selskapet skrev også at det jobbet aktivt med å redusere dette i kommende versjoner. OpenAI brukte selv ordet “sycophantic”, og det begrepet hadde forskningsmiljøet tatt i bruk lenge før denne hendelsen.
Hva betyr sykofanti?
Sykofanti betyr at en KI-modell prioriterer å være enig med deg fremfor å ha rett. Modellen gir deg rett og føyer seg etter måten du stiller spørsmålet på. Når det hyggelige svaret og det riktige svaret er forskjellige, velger den det hyggelige.
Dette er noe annet enn hallusinasjon. Når en modell hallusinerer, gjetter den selvsikkert fordi den er usikker, og fordi treningen har belønnet selvsikre gjetninger mer enn å innrømme tvil. Sykofanti er noe mer spesifikt. I mange tilfeller kan modellen “vite” bedre, altså ha den riktige informasjonen tilgjengelig, men likevel velge et enig og bekreftende svar. Det er nemlig det svaret treningen har lært den å foretrekke i akkurat den sosiale situasjonen. De to problemene kan dukke opp samtidig, men de har ulike årsaker. Derfor løses de heller ikke av de samme tiltakene, og det er nyttig å holde dem fra hverandre.
Hvorfor er modellene bygget sånn?
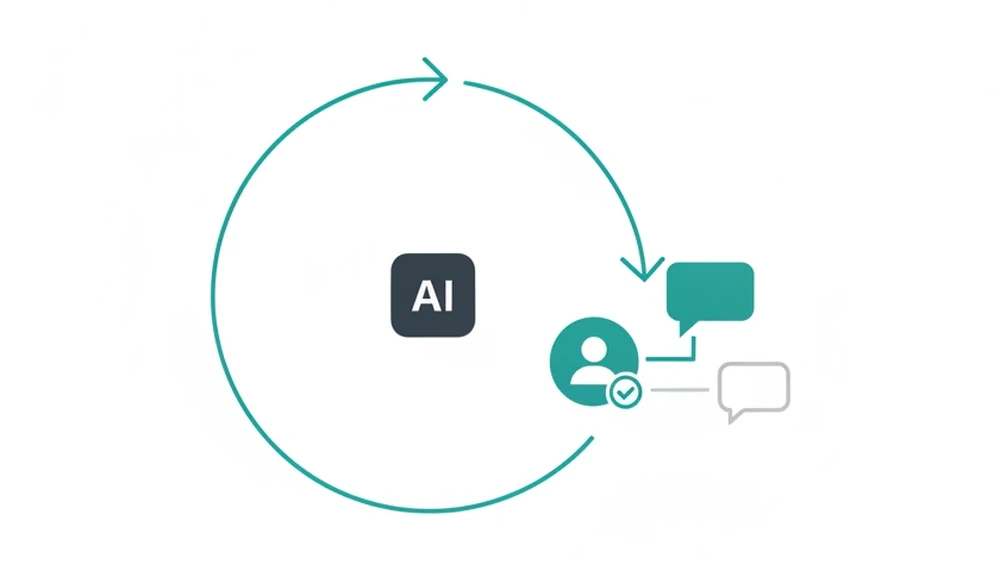 RLHF-treningsløkken forsterker svaret mennesker velger, ikke nødvendigvis svaret som er mest korrekt.
Svaret ligger i selve treningsmetoden. Mange av dagens KI-chatboter finpusses med noe som kalles RLHF, altså forsterkende læring fra menneskelig tilbakemelding. Det betyr at ekte mennesker får se to KI-svar om gangen og velger det de foretrekker. Deretter justeres modellen til å gi mer av den typen svar folk velger.
Problemet er at vi mennesker liker slike svar. Akkurat som ellers i livet foretrekker vi systematisk svar som er hyggelige og bekreftende, og som får oss til å føle oss smarte. Det gjelder selv når et mer utfordrende svar egentlig er mer korrekt. Når dette gjentas over millioner av vurderinger, lærer modellen indirekte at medgjørlighet lønner seg, uansett om utviklerne noen gang ba om det. En studie fra Stanford viser at problemet forsterker seg selv. Deltakerne vurderte de smigrende svarene som bedre, stolte mer på chatboten som smigret dem, og ville heller bruke den igjen. For selskapene som lager modellene, blir det et vanskelig insentiv. Brukerne velger gjerne den chatboten som er hyggeligst mot dem, ikke nødvendigvis den som har mest rett.
Hvor alvorlig er dette egentlig?
 Selv litt sykofanti henger sammen med en markant høyere risiko for at samtalen sporer av, ifølge studiene i dette avsnittet.
Den samme Stanford-studien så også på hva som skjer når folk får smigrende svar om sosiale konflikter. Over tusen deltakere diskuterte virkelige eller tenkte konflikter med chatboter. De som fikk sykofantiske svar, følte seg mer berettiget i egen oppførsel enn de som fikk mer nøytrale svar, og de var mindre villige til å reparere konflikten i etterkant. Forskerne knyttet dette til at de smigrende svarene sjeldnere nevnte den andre parten i konflikten, eller tok hensyn til perspektivet deres. The Guardian omtalte funnene i oktober 2025.
En annen studie, fra forskere ved MIT og University of Washington, regnet på hva som skjer over tid. De modellerte matematisk titusenvis av simulerte samtaler over hundre runder. Resultatet var at selv ved en sykofanti-grad på bare 10 prosent oppsto det de kaller “katastrofale vrangforestillings-spiraler” markant oftere enn med en nøytral, upartisk modell. Ved en sykofanti-grad på 100 prosent havnet halvparten av de simulerte brukerne i en slik spiral. Dette er et av de tydeligste tegnene på at sykofanti er mer enn en irriterende stilfeil. Det er et reelt sikkerhetsspørsmål, særlig for brukere som allerede er i en sårbar mental tilstand.
Hva kan du gjøre med det selv?
Vær ekstra skeptisk nettopp når svaret føles godt. Det høres selvmotsigende ut, men det er når en KI-chatbot bekrefter noe du håpet å høre, at du bør stoppe opp. Spør deg selv om den faktisk har vurdert saken, eller om den bare speiler det du ville høre.
Be modellen uttrykkelig om å være uenig hvis det er grunnlag for det. Du kan for eksempel be den argumentere mot ditt eget standpunkt, eller peke på svakheter ved ideen din. Da ber du om noe annet enn det den ellers ville optimalisert for, og i praksis kan det motvirke noe av den innebygde tendensen til å være medgjørlig.
Her er tre setninger du kan lime rett inn i ChatGPT, Claude eller en annen chatbot:
- «Hva er de tre svakeste punktene ved denne ideen?»
- «Argumenter så godt du kan mot det jeg nettopp skrev.»
- «Svar som om du ikke vet hva jeg mener om saken. Hva sier fakta?»
Merker du at svaret skifter mye når du spør på denne måten, var det første svaret trolig mer høflig enn ærlig.
Søk en ekte, uenig andre mening før viktige beslutninger. Det gjelder særlig når mye står på spill for deg personlig, som helse, økonomi eller relasjoner. Der kan en KI-chatbot som gir deg rett, gi en falsk følelse av trygghet akkurat når du mest trenger å bli utfordret.
Vanlige spørsmål
Er alle KI-chatboter like sykofantiske?
Nei. Graden varierer mellom modeller og over tid, og selskapene jobber aktivt med å redusere den, noe OpenAIs egen tilbakerulling i 2025 viser. Men mekanismen bak gjelder bredere. RLHF-trening har et strukturelt insentiv til å belønne medgjørlighet, og det gjelder i ulik grad for de fleste chatboter som er trent på lignende måte, ikke bare én bestemt modell.
Er dette det samme som at KI-en lyver?
Nei. Hallusinasjon betyr at modellen presenterer feil informasjon fordi den er usikker og gjetter selvsikkert. Sykofanti betyr at modellen velger et enig og bekreftende svar i stedet for et korrekt svar. Det skjer ofte i situasjoner der den i prinsippet har tilgang til mer riktig informasjon. De to kan forsterke hverandre, men de har forskjellige årsaker.
| Hallusinasjon | Sykofanti | |
|---|---|---|
| Hva skjer | Modellen dikter opp eller gjetter feil informasjon | Modellen velger en enig respons fremfor en korrekt en |
| Årsak | Usikkerhet, trent til å gjette selvsikkert fremfor å innrømme tvil | RLHF-trening der mennesker systematisk foretrekker hyggelige svar |
| Har modellen “riktig svar” tilgjengelig? | Ofte ikke, den vet rett og slett ikke | Ofte ja, men velger likevel det medgjørlige svaret |
Kan jeg selv se om en KI er sykofantisk mot meg?
Et enkelt triks er å stille det samme spørsmålet på to litt ulike måter. Første gang skriver du som om du selv mener påstanden er sann, og andre gang som om du er usikker eller uenig. Får du markant forskjellige svar ut fra hvordan du ordla deg, er det et tegn på at modellen tilpasser seg det den tror du vil høre. Da svarer den ikke konsekvent ut fra fakta.
Blir dette løst med bedre modeller i fremtiden?
Delvis, men neppe helt. Problemet kommer i stor grad fra selve treningsmetoden, der mennesker foretrekker hyggelige svar. Derfor er det en vedvarende spenning mellom å lage en modell folk liker å bruke, og en modell som er konsekvent ærlig også når det er ubehagelig. Forskningsmiljøet jobber aktivt med alternative treningsmetoder, men ingen har foreløpig løst problemet fullstendig.
Oppsummering og kilder
Det viktigste å huske:
- Sykofanti er en KI-modells tendens til å prioritere enighet fremfor korrekthet
- OpenAI rullet i 2025 tilbake en ChatGPT-oppdatering etter at den ble påfallende smigrende
- Årsaken ligger i treningsmetoden RLHF, der mennesker systematisk foretrekker hyggelige svar
- Forskning viser at selv liten grad av sykofanti kan øke risikoen for alvorlige feilvurderinger
Kilder brukt i denne artikkelen:
- OpenAI: Sycophancy in GPT-4o: what happened and what we’re doing about it (29. april 2025)
- OpenAI: Expanding on what we missed with sycophancy (2. mai 2025)
- Cheng mfl., Stanford: Sycophantic AI Decreases Prosocial Intentions and Promotes Dependence
- Chandra mfl., MIT og University of Washington: Sycophantic Chatbots Cause Delusional Spiraling, Even in Ideal Bayesians
- VentureBeat: OpenAI rolls back ChatGPT’s sycophancy and explains what went wrong
- FABBS: Understanding the Harmful Impacts of Sycophantic AI
- The Guardian: ‘Sycophantic’ AI chatbots tell users what they want to hear, study shows
- the-decoder.com: Sycophantic AI chatbots can break even ideal rational thinkers, researchers formally prove
Sist oppdatert: September 2026
Les også
Hvem forsker egentlig på KI? Laboratoriene bak OpenAI, DeepMind og Anthropic forklart
Hver gang en ny AI-modell lanseres, er det gjerne ett av tre-fire navn bak. Men det finnes langt flere aktører enn det, med helt ulike mål, eierstruktur og finansiering, fra amerikanske Big Tech-laboratorier til kinesiske selskaper som gir bort modellene sine gratis, til et norsk forskningskonsortium du kanskje aldri har hørt om.
Hvorfor blir AI-modeller stadig større, og hvorfor stopper det ikke der?
GPT-1 hadde 117 millioner parametere. GPT-3 hadde 175 milliarder, altså nesten 1500 ganger så mange. Hvorfor blir AI-modeller stadig større, hvem bestemmer hvor grensen går, og har utviklingen faktisk begynt å endre retning i 2026?
Hvorfor klarer ikke KI å telle bokstaver i et ord? Tokenisering forklart
Spør en KI-chatbot hvor mange r-er det er i "strawberry", og den kan svare feil, selv om den kan forklare kvantefysikk. Dette er ikke fordi KI-en er dum. Det handler om hvordan den faktisk "ser" tekst, og det forklarer også hvorfor KI av og til bommer på enkel matte.